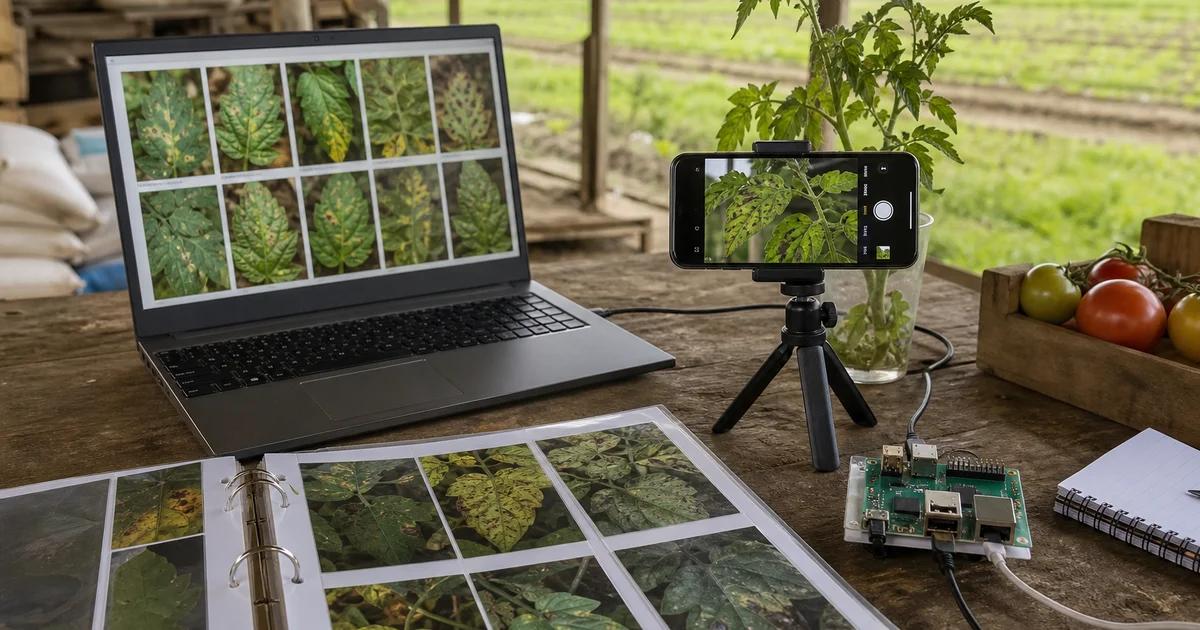
Готовая модель увидела на вашем листе что-то странное? Откройте снимок, сверьте формат программы и найдите свою культуру в её классах. После первого запуска на Raspberry Pi можно попробовать обучение на фотографиях хозяйства. Пройдём путь от понятных подписей до своей модели и разберём её ответы.
Здесь разберём полный учебный цикл: собрать фотографии, проверить подписи, разделить растения между выборками, обучить классификатор и перенести его на Pi. Основы архитектур — в сравнении CNN, RNN и LLM; организация съёмки — в статье об ESP32-CAM для наблюдений. Это лабораторная классификация одного изображения; причины заболеваний и решения об обработке проверяются отдельно.
Выбираем одну культуру и понятные признаки
Начните с признака, который можно уверенно подписать. Если виден белый налёт, описывайте именно его, пока причина не подтверждена. Названия заболеваний сохраняйте точными: фитофтороз и бурая пятнистость требуют разных определений. Такая ясность поможет и разметчику, и проверке модели.
Сделайте короткую карточку каждого класса: что в него входит, кто проверяет примеры и куда откладывать сомнения. «Без видимых симптомов» хорошо описывает наблюдение. Неясные кадры сохраняйте отдельно до проверки; способность отвергать незнакомые изображения потребуется оценивать специально.
Собираем разные растения, места и условия
Считайте независимые растения и серии вместе с числом файлов. Несколько кадров одного листа удобны для опыта, но разнообразие появится с другими растениями и условиями. Первую подборку используйте для проверки программы и понятности подписей.
Посмотрите, каких сортов, стадий и условий света не хватает. Добавляйте реальные примеры там, где проверка показывает пробел. Для редких состояний ведите сбор по мере их появления и сохраняйте происхождение каждого кадра.
Организуем съёмку, которую можно повторить
- Определите будущий способ использования: отдельный лист крупным планом или кадр стационарной камеры. Обучающие изображения должны соответствовать этой задаче.
- Выбирайте расстояние по фокусировке камеры и видимости признака. Универсальной дистанции для всех объективов нет.
- Снимайте разные растения при характерном для работы освещении. Для разных классов используйте сопоставимые фоны и условия.
- Сохраняйте исходные фотографии; отметки и подписи ведите отдельно, чтобы модель не училась распознавать маркер или табличку.
- Записывайте идентификатор растения, дату, участок, камеру и основание подписи. Пример имени файла:
gh2_plant014_20260927_001.jpg; это условная схема именования. - Смазанные, слишком тёмные и неразличимые кадры отправляйте на повторную съёмку или в отдельный архив качества.
Разделяем растения до начала обучения
Создайте dataset/manifest.csv: путь к файлу, класс, группа и выборка. Снимки можно держать в удобных подпапках, а таблица поможет проследить родственные серии. Замените условное symptom_a своим однозначно описанным признаком.
path,label,group,split
photos/a01.jpg,no_visible_symptoms,plant_a,train
photos/a02.jpg,symptom_a,plant_b,train
photos/b01.jpg,no_visible_symptoms,plant_c,val
photos/b02.jpg,symptom_a,plant_d,val
photos/c01.jpg,no_visible_symptoms,plant_e,test
photos/c02.jpg,symptom_a,plant_f,test
Шесть строк ниже показывают формат таблицы. В train модель учится, val помогает выбрать настройки и остановку, test ждёт итоговой оценки. Все фотографии одного растения и их производные поместите в одну группу и выборку. Если связана целая сессия или соседние растения, расширьте группу до этого уровня.
Группы распределяют до обучения. В этом примере каждый класс должен быть представлен во всех трёх выборках; при нехватке независимых групп скрипт останавливается. Он также обнаруживает одинаковые файлы в разных выборках, но не распознаёт визуально похожие кадры с другими именами: это остаётся задачей подготовки данных. Принцип разделения связанных наблюдений описан в документации scikit-learn.
Берём готовую основу и учим новый выходной слой
Используем MobileNetV2 с весами ImageNet и новым выходным слоем под свои классы. Основную сеть оставим замороженной: обучается только классификатор поверх извлечённых признаков. Такой этап переноса обучения описан в официальном руководстве TensorFlow. Частичное размораживание основы — отдельный эксперимент после этого этапа, с меньшим шагом обучения и повторным выбором настроек по val; приведённый скрипт его не выполняет.
Для опыта выбраны кадр 224×224, alpha=0.35, пакет из восьми изображений, до десяти эпох и Adam с шагом 1e-3. EarlyStopping наблюдает за потерей на val: после трёх эпох без улучшения останавливается и возвращает лучшие веса. Посмотрите на этот ход обучения прежде, чем менять параметры.
MobileNetV2 ожидает значения от −1 до 1. Поэтому преобразование x / 127.5 − 1 встроено в модель слоем Rescaling. Обе программы ниже передают в неё RGB в диапазоне 0–255, учитывают ориентацию EXIF и одинаково меняют размер через Pillow BILINEAR. Дополнительно делить пиксели на 255 нельзя.
Испытанное окружение — Linux ARM64, Python 3.12, TensorFlow 2.21.0, Keras 3.15.1, NumPy 2.5.3, Pillow 12.3.0 и ai-edge-litert 2.2.0. Команды выполняются на компьютере для обучения в отдельном каталоге. Установка пакетов и первая загрузка весов требуют Интернета; сами фотографии программа не отправляет наружу. Совместимость этих команд с другими ОС и версиями Python здесь не проверена.
python3.12 -m venv .venv
. .venv/bin/activate
python -m pip install --only-binary=:all: tensorflow==2.21.0 keras==3.15.1 numpy==2.5.3 pillow==12.3.0 ai-edge-litert==2.2.0
python -m pip check
Сохраните следующий файл как train.py рядом с папкой dataset. Скрипт намеренно использует CPU и ограничивает число потоков. Он принимает только одиночные JPEG/PNG; ограничения 20 MiB и 16 миллионов пикселей выбраны автором для этого примера. Исходники большего размера заранее подготовьте одинаковым способом для всех выборок, сохранив оригиналы отдельно.
import os
os.environ['CUDA_VISIBLE_DEVICES'] = '-1'
os.environ['TF_CPP_MIN_LOG_LEVEL'] = '2'
import argparse, csv, hashlib, json, re
from pathlib import Path
import numpy as np
from PIL import Image, ImageOps
import tensorflow as tf
from ai_edge_litert.interpreter import Interpreter

tf.config.threading.set_intra_op_parallelism_threads(2)
tf.config.threading.set_inter_op_parallelism_threads(1)
SIZE = 224

def pixels(path):
    if path.stat().st_size > 20 * 1024 * 1024:
        raise ValueError('Файл больше 20 MiB')
    with Image.open(path) as im:
        if im.format not in ('JPEG', 'PNG') or getattr(im, 'n_frames', 1) != 1:
            raise ValueError('Нужен одиночный JPEG или PNG')
        if im.width * im.height > 16_000_000:
            raise ValueError('Изображение больше 16 млн пикселей')
        im = ImageOps.exif_transpose(im).convert('RGB')
        return np.asarray(im.resize((SIZE, SIZE), Image.Resampling.BILINEAR), dtype=np.float32)

def read_manifest(root):
    root = root.resolve()
    with (root / 'manifest.csv').open(newline='', encoding='utf-8') as f:
        reader = csv.DictReader(f)
        if reader.fieldnames != ['path', 'label', 'group', 'split']:
            raise ValueError('Заголовок: path,label,group,split')
        rows = list(reader)
    if not rows:
        raise ValueError('Пустая разметка')
    groups, hashes, paths = {}, {}, set()
    for r in rows:
        if None in r or any(not v for v in r.values()):
            raise ValueError('Пустая или лишняя ячейка')
        if r['split'] not in ('train', 'val', 'test') or not re.fullmatch(r'[a-z][a-z0-9_]*', r['label']):
            raise ValueError('Неверный split или label')
        p = (root / r['path']).resolve()
        if not p.is_relative_to(root) or not p.is_file() or p in paths:
            raise ValueError('Неверный или повторный путь')
        paths.add(p)
        pixels(p)
        digest = hashlib.sha256(p.read_bytes()).hexdigest()
        for seen, key in ((groups, r['group']), (hashes, digest)):
            if key in seen and seen[key] != r['split']:
                raise ValueError('Утечка: группа или одинаковый файл в разных выборках')
            seen[key] = r['split']
        r['file'] = p
    labels = sorted({r['label'] for r in rows})
    if len(labels) < 2:
        raise ValueError('Нужно минимум два класса')
    for split in ('train', 'val', 'test'):
        if {r['label'] for r in rows if r['split'] == split} != set(labels):
            raise ValueError('Каждый класс нужен в train, val и test')
    return rows, labels

def dataset(rows, labels, split, batch):
    selected = [r for r in rows if r['split'] == split]
    def generate():
        for r in selected:
            yield pixels(r['file']), np.int32(labels.index(r['label']))
    ds = tf.data.Dataset.from_generator(generate, output_signature=(
        tf.TensorSpec((SIZE, SIZE, 3), tf.float32), tf.TensorSpec((), tf.int32)))
    if split == 'train':
        ds = ds.shuffle(len(selected), seed=42)
    options = tf.data.Options()
    options.threading.private_threadpool_size = 1
    return ds.batch(batch).with_options(options), selected

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument('dataset', type=Path)
    parser.add_argument('output', type=Path)
    parser.add_argument('--epochs', type=int, default=10)
    parser.add_argument('--batch', type=int, default=8)
    args = parser.parse_args()
    if args.epochs < 1 or args.batch < 1:
        raise ValueError('epochs и batch должны быть положительными')
    rows, labels = read_manifest(args.dataset)
    args.output.mkdir(parents=True, exist_ok=False)
    tf.keras.utils.set_random_seed(42)
    train, _ = dataset(rows, labels, 'train', args.batch)
    val, _ = dataset(rows, labels, 'val', args.batch)
    test, test_rows = dataset(rows, labels, 'test', args.batch)
    base = tf.keras.applications.MobileNetV2(
        input_shape=(SIZE, SIZE, 3), alpha=0.35, include_top=False, weights='imagenet')
    base.trainable = False
    inputs = tf.keras.Input(shape=(SIZE, SIZE, 3))
    x = tf.keras.layers.Rescaling(1 / 127.5, offset=-1)(inputs)
    x = base(x, training=False)
    x = tf.keras.layers.GlobalAveragePooling2D()(x)
    outputs = tf.keras.layers.Dense(len(labels), activation='softmax')(x)
    model = tf.keras.Model(inputs, outputs)
    model.compile(optimizer=tf.keras.optimizers.Adam(1e-3),
                  loss='sparse_categorical_crossentropy', metrics=['accuracy'])
    history = model.fit(train, validation_data=val, epochs=args.epochs, verbose=2,
        callbacks=[tf.keras.callbacks.EarlyStopping(monitor='val_loss', patience=3,
                                                   restore_best_weights=True)])
    model.save(args.output / 'model.keras')
    converter = tf.lite.TFLiteConverter.from_keras_model(model)
    data = converter.convert()
    (args.output / 'model.tflite').write_bytes(data)
    runtime = Interpreter(model_content=data, num_threads=1)
    runtime.allocate_tensors()
    inp, out = runtime.get_input_details()[0], runtime.get_output_details()[0]
    if list(inp['shape']) != [1, SIZE, SIZE, 3] or inp['dtype'] != np.float32:
        raise ValueError('Неожиданный вход TFLite')
    matrix = np.zeros((len(labels), len(labels)), dtype=np.int64)
    max_error = 0.0
    for r in test_rows:
        image = pixels(r['file'])[None]
        expected = model(image, training=False).numpy()[0]
        runtime.set_tensor(inp['index'], image)
        runtime.invoke()
        scores = runtime.get_tensor(out['index'])[0]
        if not np.allclose(scores, expected, atol=1e-4, rtol=1e-4):
            raise ValueError('Выход TFLite отличается от Keras')
        max_error = max(max_error, float(np.max(np.abs(scores - expected))))
        matrix[labels.index(r['label']), int(np.argmax(scores))] += 1
    recall = np.diag(matrix) / matrix.sum(axis=1)
    precision = [float(matrix[i, i] / matrix[:, i].sum()) if matrix[:, i].sum() else None
                 for i in range(len(labels))]
    manifest = {'labels': labels, 'input_shape': [1, SIZE, SIZE, 3],
        'input_dtype': 'float32', 'input_range': 'RGB 0..255',
        'resize': 'Pillow BILINEAR, EXIF transpose',
        'model_sha256': hashlib.sha256(data).hexdigest()}
    report = {'labels': labels, 'confusion_rows_true_columns_predicted': matrix.tolist(),
        'test_count': len(test_rows), 'recall': recall.tolist(), 'precision': precision,
        'tflite_max_absolute_error': max_error, 'history': history.history,
        'versions': {'tensorflow': tf.__version__, 'numpy': np.__version__}}
    (args.output / 'manifest.json').write_text(json.dumps(manifest, indent=2), encoding='utf-8')
    (args.output / 'report.json').write_text(json.dumps(report, indent=2), encoding='utf-8')
    (args.output / 'dataset.csv').write_bytes((args.dataset / 'manifest.csv').read_bytes())
    print('Готово:', args.output, '; это проверка программы, не допуск к применению.')

if __name__ == '__main__':
    main()
python train.py dataset run-01 --epochs 10 --batch 8
python -m pip freeze > run-01/requirements.txtКаждый опыт сохраняйте в новый каталог. После ошибки оставьте журнал, исправьте причину и выберите другое имя. На выходе получите Keras, TFLite, описание входа и классов, таблицу данных и отчёт. Исходные фотографии храните как отдельную неизменяемую версию набора.
Открываем ошибки и смотрим на исходные фотографии
В report.json найдите матрицу ошибок: строки — настоящие классы, столбцы — ответы, порядок задан в labels. Recall показывает, какую долю класса нашли, precision — какая доля ответов этого класса верна. При отсутствии таких ответов precision будет null. Выберите несколько ошибочных ячеек и вернитесь к снимкам.
Рядом с метриками посмотрите число групп и примеров каждого класса. Сравните с простым базовым вариантом и разберите редкие состояния отдельно. Настройки выбирайте по train и val, сохраняя test для итогового сравнения.
Значения softmax не являются автоматически вероятностью болезни; проблема калибровки описана, например, в работе Guo и соавторов. Произвольный порог 60–70% не обеспечивает безопасного отказа. Ненужный объект, темнота или новый сорт могут получить высокий балл одного из известных классов. Порог и отдельные правила качества кадра проверяют на подходящих независимых данных, а спорный результат передают человеку.
Переносим свой комплект на Raspberry Pi
Скрипт уже экспортирует TFLite и пропускает каждый тестовый кадр через обе версии. Сравнение с atol=1e-4 и rtol=1e-4 проверяет совпадение вычислений после экспорта. Качество классификации оцениваем по отдельным метрикам и фотографиям.
Перенесите вместе model.tflite и manifest.json в отдельную папку на Pi. В описании записаны порядок классов, формат входа и SHA256 модели. Хеш обнаружит случайное несовпадение файла с описанием, но не является цифровой подписью: используйте собственный проверенный комплект. Отдельный labels.txt здесь не нужен.
Скрипт из статьи о готовой модели нельзя использовать заменой одного имени файла: там фиксированы другая модель, размер и классы. Здесь нужен predict_farm.py ниже. Для него достаточно окружения с ai-edge-litert, NumPy и Pillow из инструкции подготовки Raspberry Pi; TensorFlow на Pi для распознавания не требуется.
import argparse, hashlib, json
from pathlib import Path
import numpy as np
from PIL import Image, ImageOps
from ai_edge_litert.interpreter import Interpreter

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument('bundle', type=Path)
    parser.add_argument('image', type=Path)
    args = parser.parse_args()
    meta = json.loads((args.bundle / 'manifest.json').read_text(encoding='utf-8'))
    data = (args.bundle / 'model.tflite').read_bytes()
    if hashlib.sha256(data).hexdigest() != meta['model_sha256']:
        raise ValueError('Модель не совпадает с manifest.json')
    labels = meta['labels']
    if not isinstance(labels, list) or len(labels) < 2 or any(not isinstance(x, str) or not x for x in labels):
        raise ValueError('Неверные метки классов')
    if len(set(labels)) != len(labels):
        raise ValueError('Повторные метки классов')
    if (meta['input_shape'] != [1, 224, 224, 3] or meta['input_dtype'] != 'float32'
            or meta['input_range'] != 'RGB 0..255' or meta['resize'] != 'Pillow BILINEAR, EXIF transpose'):
        raise ValueError('Несовместимая подготовка изображения')
    if args.image.stat().st_size > 20 * 1024 * 1024:
        raise ValueError('Файл больше 20 MiB')
    with Image.open(args.image) as im:
        if im.format not in ('JPEG', 'PNG') or getattr(im, 'n_frames', 1) != 1:
            raise ValueError('Нужен одиночный JPEG или PNG')
        if im.width * im.height > 16_000_000:
            raise ValueError('Изображение больше 16 млн пикселей')
        im = ImageOps.exif_transpose(im).convert('RGB')
        image = np.asarray(im.resize((224, 224), Image.Resampling.BILINEAR), dtype=np.float32)[None]
    runtime = Interpreter(model_content=data, num_threads=1)
    runtime.allocate_tensors()
    inputs, outputs = runtime.get_input_details(), runtime.get_output_details()
    if len(inputs) != 1 or len(outputs) != 1:
        raise ValueError('Нужны один вход и один выход')
    inp, out = inputs[0], outputs[0]
    if list(inp['shape']) != [1, 224, 224, 3] or inp['dtype'] != np.float32:
        raise ValueError('Неверный вход модели')
    if list(out['shape']) != [1, len(labels)] or out['dtype'] != np.float32:
        raise ValueError('Неверный выход модели')
    runtime.set_tensor(inp['index'], image)
    runtime.invoke()
    scores = runtime.get_tensor(out['index'])[0]
    if (not np.isfinite(scores).all() or np.any(scores < 0) or np.any(scores > 1)
            or not np.isclose(scores.sum(), 1, atol=1e-3)):
        raise ValueError('Некорректные оценки модели')
    for i in np.argsort(-scores, kind='stable')[:3]:
        print(f'{labels[i]}: {scores[i]:.5f}')
    print('Оценки классов не являются диагнозом или вероятностью болезни.')

if __name__ == '__main__':
    main()
# Включите окружение с ai-edge-litert, NumPy и Pillow.
# Например, если оно создано по предыдущей статье:
. ~/plant-ai/.venv/bin/activate
python predict_farm.py run-01 /полный/путь/leaf.jpgЗапустите predict_farm.py на снимке: появятся до трёх классов с оценками. Несовпадение хеша, повреждённый файл или неверный формат дадут ошибку. Сохраните прежний комплект отдельно. Для сравнения моделей выберите общую задачу и подходящие контрольные снимки.
Проверяем, что могло исказить оценку
- Разные причины объединены в один класс без ясного определения, либо один и тот же признак размечен по-разному.
- Фон, подпись на кадре или способ съёмки совпадает с классом и становится подсказкой для модели.
- Серия одного растения разошлась между выборками; переименование и небольшая обрезка не делают снимки независимыми.
- Обучение показывает хороший результат, а проверка заметно хуже. Возможные причины — переобучение, отличия данных или разметки; одного процента недостаточно для вывода.
- Изменились камера, обрезка или нормализация при переносе. Проверяйте весь путь от файла до входного массива.
- Ошибки из тестового набора добавили в обучение и продолжили сообщать прежнюю тестовую точность. После такой доработки нужен новый независимый контроль.
Планируем следующий запуск по измеренному времени
Разделите работу на сбор, подписи, выборки, вычисления и проверку в будущих условиях. Этот пример работает на CPU. Засеките свой запуск и посмотрите расход памяти: так появится основание планировать следующий опыт.
В расходы включите съёмку и хранение, время разметчика и специалиста, сопровождение и повторные проверки. Небольшой первый запуск поможет освоить весь процесс и понять, где уходит больше усилий.
Договариваемся, кто подтверждает подпись
Назначьте ответственного за определения классов и разбор разногласий. Если класс назван заболеванием, основание такой подписи должно соответствовать задаче диагностики и быть подтверждено компетентным специалистом; знакомство с теплицей само по себе этого не заменяет. Для спорных фотографий предусмотрите статус «не определено» вне обучающих классов до проверки.
Дайте разметчикам согласованные примеры и правила. Периодически сравнивайте подписи и сохраняйте историю исправлений. Ошибки модели используйте для следующего набора, оставляя действующий test неизменным.
Что собрать, если редкого состояния пока мало
Сохраняйте реальные примеры с происхождением и подтверждением. Если удобнее объединить классы в «есть видимое отклонение», сначала переопределите задачу и оценку. Тогда будет ясно, что именно модель учится различать.
Пока подтверждённых примеров мало, продолжайте ручной просмотр и сбор. Модель на обычных листьях можно изучать как эксперимент, отдельно проверяя реакцию на неизвестные состояния. По мере накопления данных вернитесь к выбранной задаче.
Пробуем фотографии стационарной камеры
Перед схемой ESP32-CAM → Pi → уведомление соберите кадры именно будущей камеры. Сравните их с ручными снимками. Для первых запусков сохраняйте кадр, время, версию и оценку — так ответ легко проверить.
Сделайте заметными отсутствие свежего кадра и ошибку обработки. Затем выберите частоту уведомлений и порядок осмотра по результатам проверки. Решения об обработке оставьте за ответственным специалистом.
Собираем результаты первого опыта
Положите рядом набор снимков, его таблицу, модель, описание и отчёт. Повторите запуск на сохранённом файле и найдите его результат. Такой комплект позволит вернуться к опыту через месяц и понять, какие данные и настройки дали этот ответ.
Теперь сравните ответы на независимых снимках хозяйства и выберите одну конкретную доработку для следующего опыта. Следующие темы серии — прогнозы по данным датчиков и камера с уведомлениями. Общая последовательность материалов собрана в путеводителе по DIY.